其实我们可以看到,residual 在 attention 中所起的作用,不只是让深度网络的训练更加稳定。它同时也定义了信息在网络中的传递方式,而更好的信息传递方式可能会带来更优的结果。
后面展开的分析其实没有什么严格的理论基础,只是从直觉上看,我认为一个方法能够 work,往往并不是因为它足够复杂,而是因为它触及了一些更简单的规律。语言模型的 scaling,实际上仍然是在基于这些简单规律建立 token 之间的关系;而对这些关系进行更高效的压缩和建模,最终形成了智能的涌现。
从建立关系的角度来说,本质上就是要获得足够的信息,同时在这些信息之间建立足够高效的连接。这也意味着,我们需要给网络提供足够的自由度,让它能够形成这些连接;同时避免过于限制性的设计,使原本直接的连接不得不绕弯建立,最终损失网络中的信息密度。
所以下面我想用一张图来分析各种 residual 方法从信息流的角度分别做了什么,进而建立一种分析和思考的方式,理解 residual 的演变,并思考什么可能是更好的方向。
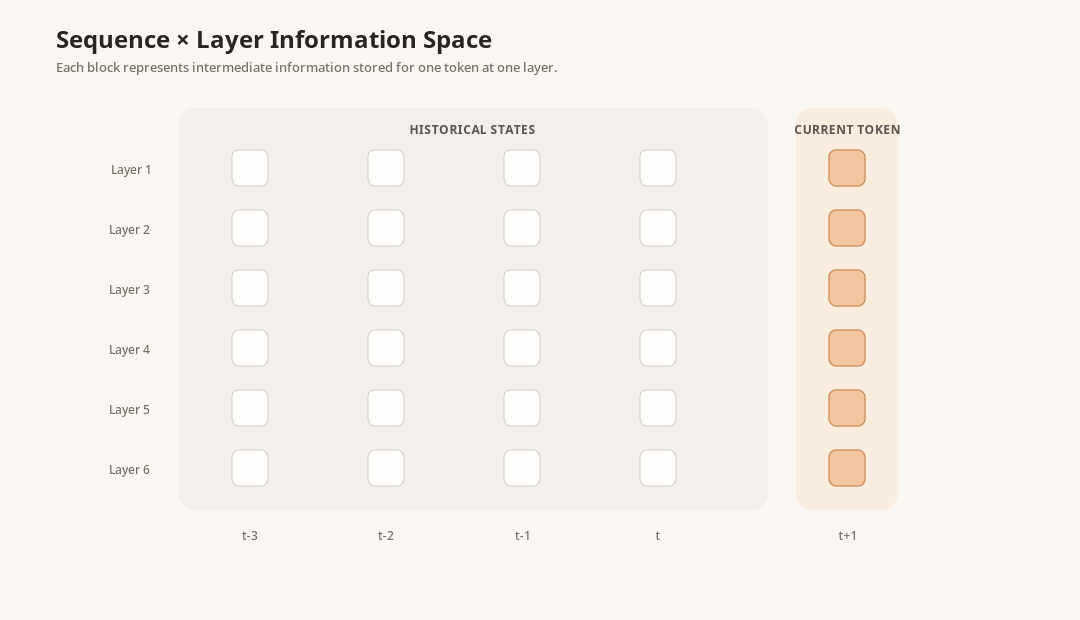
回到学习关系的视角,其实序列中的每个 token,以及这些 token 在每一层对应的 hidden state,都应该被看作由一些关系聚合得到的中间信息。对应地,模型已经存储了 KV cache,所以这里就用 KV cache 作为这些中间信息的代表。虽然它并不是直接的 hidden state,但它同样代表了从 hidden state 中,以这一层特定的方式提取出来的信息。为了方便,下面就用历史 KV 来表示历史的中间信息。
从这里可以发现,residual 在这里的含义不再只是用于稳定训练的长程分支,而是代表了一种信息流动的方式。下面逐一来看。
Standard Residual
首先从标准 residual 开始。每一层先收集这一层的历史信息,对它们进行汇总和处理,得到新的 feature;再将这个结果与之前的 residual 直接相加,交给下一层。下一层继续收集本层的历史信息,再与传下来的 residual 汇总,如此重复。
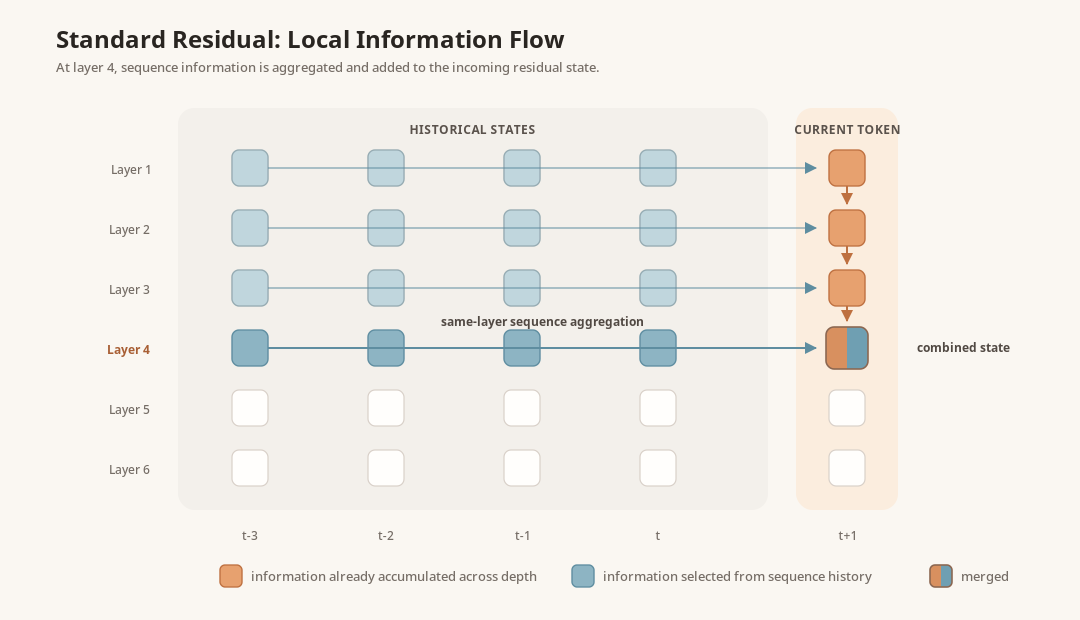
可以看到,这里存在一个明确的顺序:拿到 residual,混合当前层的信息,再交给下一层。
DenseFormer
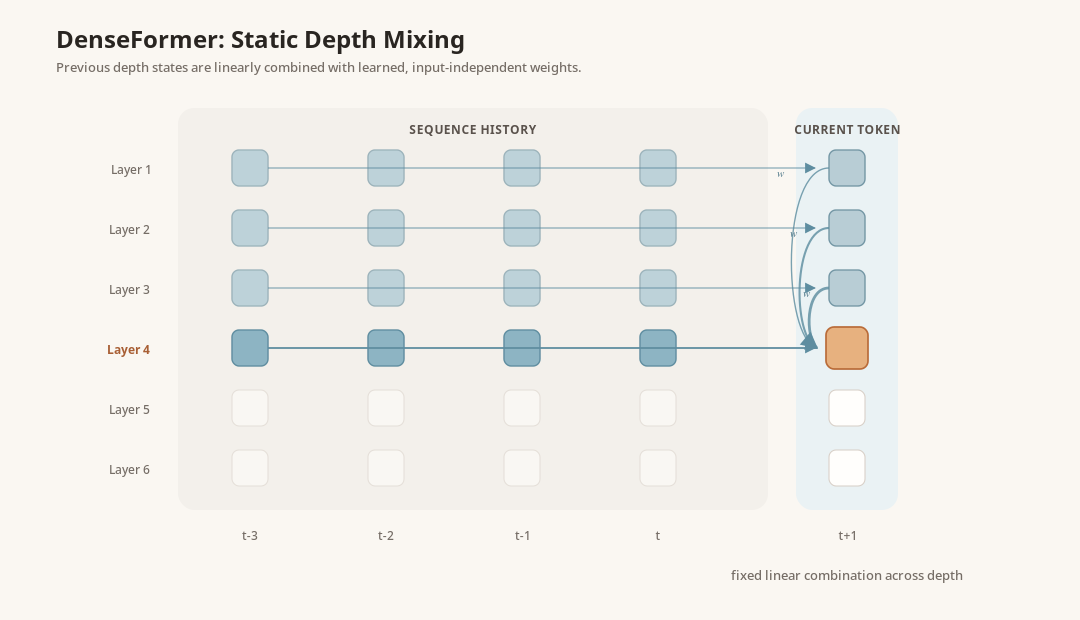
然后看 DenseFormer,它使用一组固定权重,对不同深度的历史信息进行线性组合。
Attention Residuals
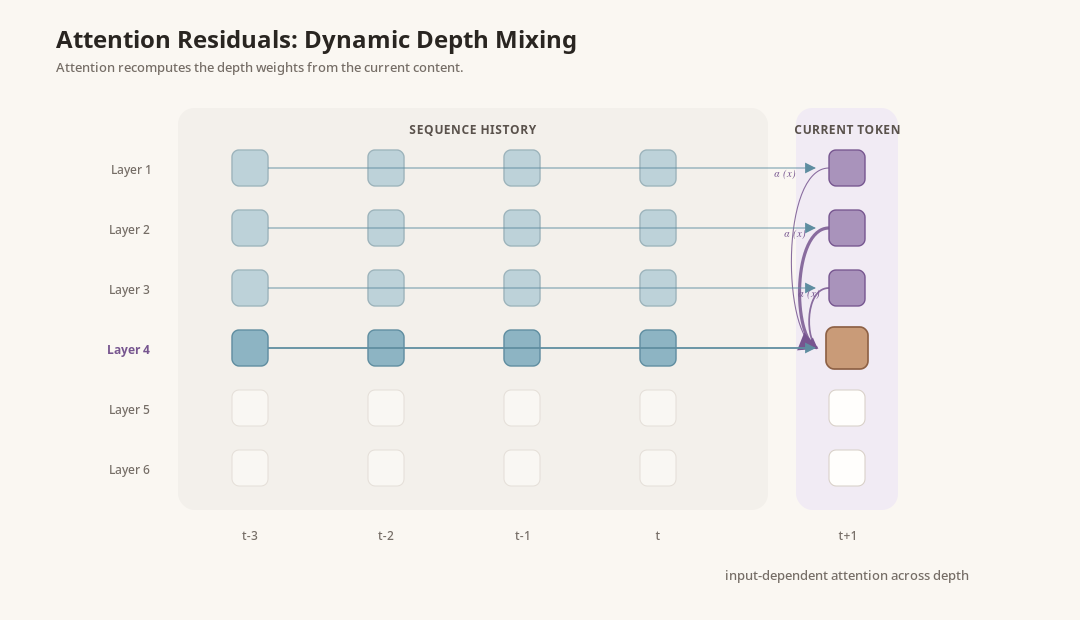
Attention Residuals 则使用 attention,再次对这些历史信息进行组合。与 DenseFormer 的固定权重不同,这里的组合权重会随当前信息动态变化。
Hyper-Connections
HC 系列并没有替代原本的 attention、MLP 等 Transformer block,而是额外维护了一个多流 residual 空间。每一层仍然会从同层的历史 token 中收集信息;这里用 $n=4$ 的 HC 表示:每一层再从四条 residual stream 中读取一个组合输入,经过正常的 Transformer block 计算,然后将结果写回四条流;原有的 residual 信息也通过流间混合矩阵,一层一层传到下一层。这个额外空间定义了历史信息如何被保留和组合,同时我们还需要约束其中信息传递的性质。
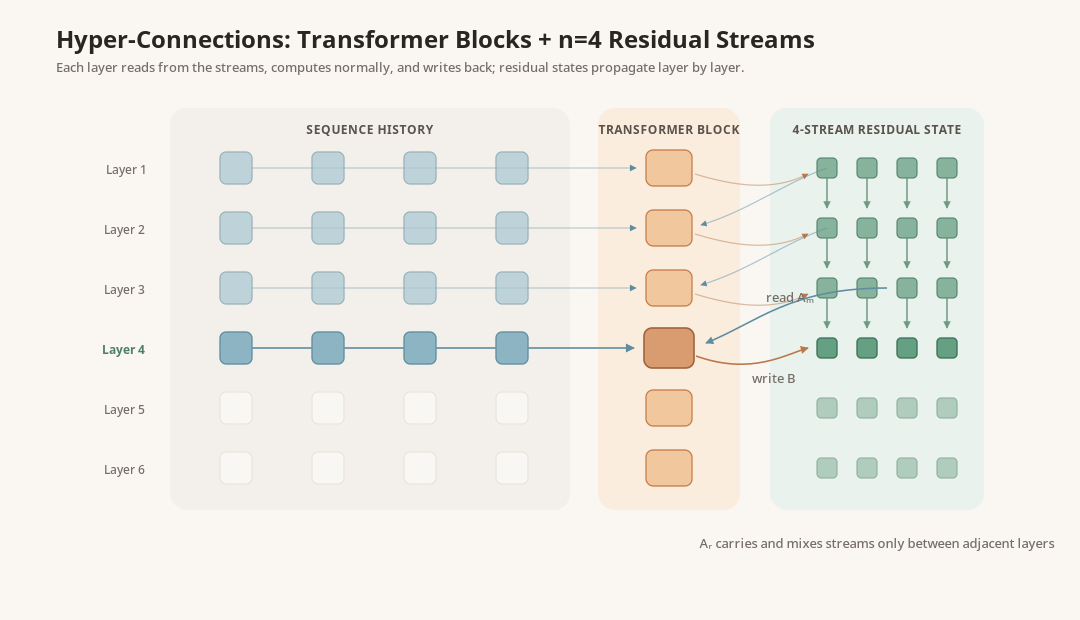
其他变体无论如何变化,都可以放到这个框架中,看成用不同方式组合过往信息的方法。
开始思考
完成上面的图示之后,我们可以进一步展开一些思考:什么样的结构,才算是充分又高效的信息连接?
首先,暂时不仔细考虑某一种具体的结构,因为所有历史 KV 的生成本身都依赖于这种结构。我们先假定已经存在某种结构:对于输入的文字序列,模型首先通过复杂的计算,提取出不同层次的信息。接下来,当模型要生成一个新的 token 时,这个 token 可能会与历史中的某一部分信息发生关联。
最直接的方式,是让当前 token 能够通过某种直接连接找到这些历史信息。例如,让它与所有历史信息直接做 attention,再完成后续的信息处理。但是显然,这种方式的计算量太大,因此我们仍然需要设计一种更节省的方式。
目前常见的方法,是先聚合同一层中的序列历史,再聚合不同层之间的信息。层内聚合通常由 attention 完成,层间聚合则可以使用 HC、Attention Residuals 或其他 residual 结构。
那么,这里是否还存在其他方式?目前这种先聚合层内历史、再聚合层间信息的方式,是否已经能够足够高效地传递信息?
第二,考虑 decode 的过程。历史 token 的深层信息其实已经生成了,对应的就是图中那些白色的小方块。也就是说,对于当前 token 尚未到达的那些层,历史 token 在对应层的信息已经是已知的。但是当前 token 仍然需要一层一层向下推进,所以这些已经聚合好的深层历史信息,在前面的层中并不会被使用。
当然,可以说输入 token 本身已经携带了一部分相关信息。但是它毕竟只是之前计算得到的一个结果,其中必然丢失了很多中间的决策路径。
一个自然的想法是:我们之前观察到的一些深层表现问题,也许并不完全来自 residual 的设计,还可能来自这种信息使用上的不对称。由于前层和中层无法访问已经存在的深层历史信息,学习过程可能会自然地限制深层表示的变化幅度,使这些层更多只是在已有表示上做小幅修正。
但对于一些细微变化会影响远期结果的复杂问题,这些关联又必须充分利用网络深度才能传递。于是就可能出现一种现象:深层对于简单问题看起来没有太大作用,但对于复杂问题又不可缺少。这是否正是由这种信息利用的不对称所带来的?我觉得这也是一个值得继续思考的问题。
总结
综合上面的两个思考,我们可以继续提出两个问题。第一,是否存在不同于这种“先横后竖”的信息聚合方式?比如选择一个 block,或者沿着一条斜线聚合信息。第二,是否可以提前读取那些已经生成的、更深层的历史信息?
这些改变会给网络带来什么影响,我觉得是一个很值得思考的问题,同时也非常需要通过实验来加深认识。只是这些实验需要的算力确实很多,我也非常希望未来能够有机会做一些尝试。